nps 内网穿透实战:一机一 Client 的隧道管理体系
摘要
家里一台 PVE 跑着七八台虚机和容器,公网只有一个 IP,怎么让每台机器都能从外面安全连上?这套方案的答案是 nps 内网穿透,外加一条硬规矩:一机一 client。每台机器独立客户端、独立备注、独立密钥,可以独立接入、独立下线、独立吊销。再配上一套签发工具链(mknpc.sh/delnpc.sh)、统一的端口池和专属一键安装器,新机器上线就是几分钟的事。本文把这套体系的设计决策、工作原理、工具链和运维经验完整记录下来。
目录
- 引言:一个公网 IP,七八台机器
- nps 的工作原理:一条隧道是怎么搭起来的
- 关键决策:一机一 Client
- 工具链:签发、安装、管理一条龙
- mknpc.sh 内部到底做了什么
- 端口池:先规划,再分配
- 签发实战:从建 Client 到机器上线
- 已签发清单
- 日常运维:gl 菜单与掉线看门狗
- 踩坑与注意事项
- 总结
引言:一个公网 IP,七八台机器
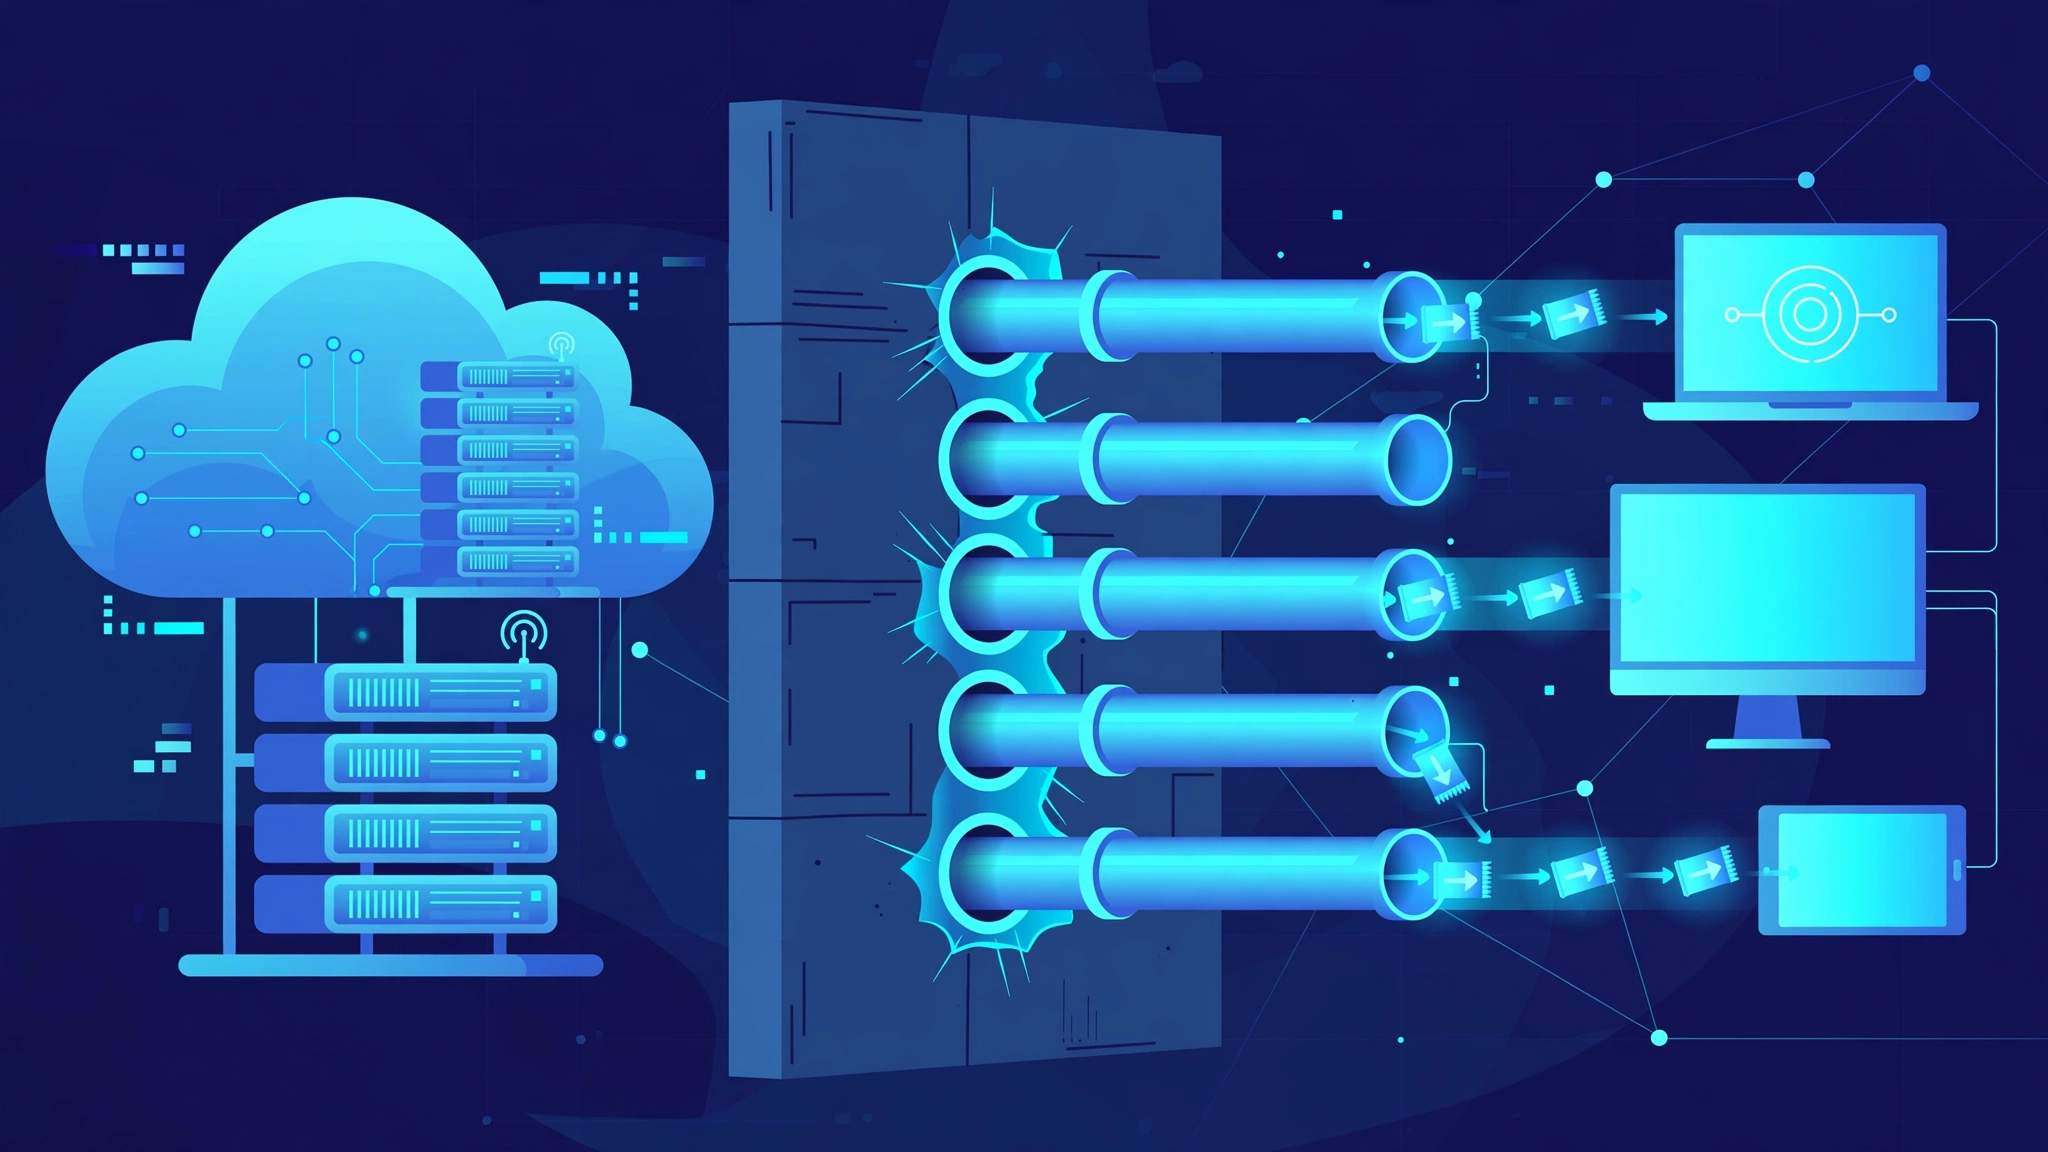
nps 是这套家庭数据中心里最核心的基础设施,没有之一。VPS 在公网(82.139.204.8)上跑 nps 服务端,家里的机器跑 npc 客户端,向服务端注册后,VPS 上的某个端口就被映射到了家里某台机器的某个端口。从此,SSH、RDP、VNC、Web 面板,全部经由隧道进出,家里不需要公网 IP,也不需要在路由器上做端口映射。
拓扑很简单:
公网用户 → VPS:22221 → nps 服务端 → npc 隧道 → 家里 PVE:22
公网用户 → VPS:28006 → nps 服务端 → npc 隧道 → PVE:8006(管理面板)
但"搭起来"只是第一步。真正的难题是管理:机器越来越多,隧道越来越多,哪个端口对应哪台机器、哪个客户端归谁、密钥在哪、怎么下线一台不再用的机器?没有成体系的管理方法,半年后就是一团乱麻。这篇文章讲的就是这套管理体系。
nps 的工作原理:一条隧道是怎么搭起来的
在讲管理体系之前,先把 nps 的工作方式说清楚,不然"一机一 client"这条规矩看起来就像拍脑袋。
nps 是经典的 C/S 反向隧道结构,服务端(nps)和客户端(npc)之间先建立一条常驻的控制连接(默认走 TCP,服务端监听 8024 之类的桥接端口)。这条控制连接平时不传业务数据,只干三件事:客户端上线注册、服务端下发隧道配置、心跳保活。
当你在服务端给某个客户端配了一条"TCP 隧道:VPS 的 22221 → 客户端内网的 22",流程是这样的:
- nps 服务端开始监听公网的 22221 端口;
- 有外部连接打到 22221,服务端通过控制连接通知对应的 npc 客户端:"来活了,给我开一条到 127.0.0.1:22 的通道";
- npc 客户端主动向外连回服务端(注意方向:是内网机器向公网发起连接,所以不需要公网 IP,也不需要路由器端口映射),并把这条新连接和刚才的外部请求"拼接"起来;
- 数据开始双向转发,SSH 握手、登录,全在这条拼接好的管道里完成。
理解这个模型,能解释很多现象:为什么家里机器不需要公网 IP(因为连接是向外打的);为什么 npc 掉线后所有隧道一起挂(控制连接断了,服务端收不到"拼接"响应);为什么隧道延迟比直连高一截(数据多绕了一次 VPS)。后面讲的掉线看门狗,保的就是第 2 步里那条控制连接。
关键决策:一机一 Client
最早的方案是:PVE 宿主机上只跑一个 npc,所有虚机的服务都经由这一个客户端做端口转发,统一出口。听起来很省事,实操中发现了问题:所有机器的隧道挤在一个客户端里,备注一多就乱,某台机器要下线或换密钥时牵一发动全身,误操作容易"串台",把别人的隧道一起影响了。
于是改成了现在这条规矩:一机一 nps client。
| 维度 | 一个 Client 转发全部(旧方案) | 一机一 Client(现行) |
|---|---|---|
| 客户端备注 | 混在一起,难分辨 | 每台机器独立备注,一眼看懂 |
| 密钥 | 共用,换一台全受影响 | 每台独立密钥 |
| 上线/下线 | 互相牵连 | 独立接入、独立下线、独立吊销 |
| 误操作风险 | 改一条隧道可能影响其他机器 | 影响范围限定在单台机器 |
代价是客户端数量变多,但 nps 管理多个客户端本来就是它的本职工作,这点开销完全可以接受。用一点点管理成本,换来的是清晰的责任边界,这笔账划算。
工具链:签发、安装、管理一条龙
规矩定了,就需要工具来执行。整套工具链放在 ~/workspace/pve-npc-menu/:
| 脚本 | 用途 |
|---|---|
npc.sh |
Debian/PVE/macOS 通用安装管理脚本,自动适配 systemd 或 launchd,提供安装、配置、启停、开机自启、状态、日志、连通性测试、卸载菜单 |
npc.ps1 |
Windows 版,以 SYSTEM 计划任务实现开机自启,功能与 sh 版对应 |
mknpc.sh |
签发器:自动创建 nps 客户端、写清晰备注、按系统类型分配隧道、生成该机器专属的一键安装器 |
delnpc.sh |
吊销器:删除客户端、关联隧道和专属安装器 |
nps-apply.py / nps-del.py |
辅助脚本,处理 nps 服务端的配置读写 |
registry.tsv |
设备登记表,权限 600,记录每台机器的客户端 ID、隧道端口等 |
脚本分发走自有域名,全部经 HTTPS:
# 通用安装脚本(公开)
https://028000.xyz/npc.sh
https://028000.xyz/npc.ps1

# 某台机器的专属一键安装器(未公开路径,签发时生成)
https://028000.xyz/i/<token>.sh
专属安装器用的是不公开的 /i/<token>.<ext> 路径,不放在目录列表里,猜不到就拿不到。这是一个小而实用的设计:安装器里带了这台机器的专属配置,公开分发等于把钥匙挂在门口。
另外一个关键设计:npc 客户端的二进制包也自托管了,地址是 https://028000.xyz/npc-bin/v0.26.10/,包含 Linux amd64/arm64、Darwin amd64、Windows amd64 构建。原因是家里网络访问 GitHub 不稳定,安装脚本优先从本站镜像下载,失败才回退 GitHub。macOS 统一用 amd64 构建(Intel 机器无需 Rosetta;该版本官方没有 Darwin arm64 包)。
安装脚本还支持非交互模式,一行命令完成安装、写配置、设开机自启并启动:
# 非交互安装(签发模板和 PVE 专属安装器都在用这个模式)
NPC_AUTO=1 bash npc.sh
mknpc.sh 内部到底做了什么
签发器不是魔法,它就是把原来要在 nps Web 后台里点十几下的操作,写成了可重复执行的脚本。一台新机器签发时,它按顺序做这几件事:
- 查端口占用:读 nps 服务端的现有隧道任务,再对照
registry.tsv登记表,按端口池规则(见下节)挑出空闲端口,冲突的自动跳过; - 写服务端配置:往
/etc/nps/conf/clients.json里追加一个新客户端(备注、密钥),往tasks.json里追加它的隧道任务; - 重启 nps 生效:
systemctl restart nps,然后确认服务为 active、新端口确实在监听; - 登记:把客户端 ID、备注、分配的隧道端口、安装器 token 路径写进
registry.tsv; - 生成专属安装器:按模板渲染出这台机器的一键安装脚本,放到网站的
/i/<token>.sh,里面已经写好了服务器地址、客户端密钥和备注,目标机器上bash <(curl …)一行就装完。
吊销(delnpc.sh)就是逆过程:删客户端、删隧道、删安装器、清登记表,最后重启 nps 确认其他客户端不受影响。之前做过完整自检:建临时测试客户端、验证远端 clients.json/tasks.json 写入正确、确认新端口监听、安装器可下载,再用 delnpc.sh 删干净,全程无残留。
把"点后台"变成"跑脚本"的好处,不只是省时间:每一次签发和吊销都有迹可循,registry.tsv 就是全部隧道的总账。这正是架构总纲里"每活必留痕"的落地。
端口池:先规划,再分配
端口先规划好,签发器按规则自动分配,避免冲突。mknpc.sh 在签发时会检查 nps 现有任务和登记表,自动跳过已被占用的端口。
| 用途 | 起始端口 | 说明 |
|---|---|---|
| SSH | 22221 起 | 每台机器递增:PVE 用 22221,Mac 用 22222,办公虚机用 22223 |
| Windows RDP | 23389 起 | 办公虚机的 RDP 用了 23390 |
| macOS VNC | 25900 起 | 屏幕共享 |
| Web 管理 | 28xxx | PVE 面板、DSM、应用服务等走这个段 |
规划时特意把不同用途分在不同号段,看到端口号就能猜出用途。22221 一看就是某台机器的 SSH,28xxx 一看就是 Web 管理入口。这种"端口即文档"的习惯,在排查问题时能省不少时间。
签发实战:从建 Client 到机器上线
以签发办公虚机 VM1002 为例,完整流程是这样的:
# 1. 在 VPS 上运行签发器(交互式确认机器信息)
./mknpc.sh
# 签发器自动完成:创建 nps 客户端 → 备注写为 debian-office-办公助手
# → 分配 22223→SSH、23390→RDP → 生成专属一键安装器

# 2. 在目标机器上运行专属安装器(一行命令)
bash <(curl -fsSL https://028000.xyz/i/<token>.sh)
# 安装器内部以 NPC_AUTO=1 非交互模式完成全部安装

# 3. 在 VPS 上验证隧道
# 22223 应返回对应机器的 OpenSSH banner
# 23390 的 TCP/RDP 应可达
签发完成后,还要把检查项加进 /root/pve-mgmt/check-tunnel.sh,这样日常巡检会自动覆盖新隧道。目前这个检查脚本覆盖了 nps 本体、22221/22223/23390/28006/28100 等端口、PVE SSH 与面板、DSM、办公虚机的 SSH/RDP,一共十几项。
吊销同样简单,一台机器退役时:
# 删除客户端、关联隧道、专属安装器,并清理登记表
./delnpc.sh
删除后会重启 nps 并确认服务仍为 active,确保不影响其他客户端。之前做过完整自检:建临时测试客户端、验证远端 clients.json/tasks.json 写入正确、确认新端口监听、安装器可下载,再用 delnpc.sh 删干净,全程无残留。
已签发清单
截至目前的签发情况:
| Client ID | 备注 | 隧道 |
|---|---|---|
| 2 | Win(旧客户端) | 8808 → 192.168.0.126:3389(RDP),保持未动 |
| 3 | home-pve-宿主机 | 22221 → PVE 的 22(SSH);28006 → PVE 的 8006(管理面板) |
| 4 | home-mac-主机 | 22222 → SSH;25900 → VNC(屏幕共享) |
| 5 | debian-office-办公助手 | 22223 → VM1002 的 22(SSH);23390 → VM1002 的 3389(RDP) |
另外还有配套设施:VPS 到 PVE 的免密 SSH(专用密钥,ssh pve-home 经 127.0.0.1:22221 直达),以及 DSM 的 HTTPS 隧道(VPS 28100 → 192.168.0.106:5001),后者在 WireGuard 那篇文章里还会讲到。
日常运维:gl 菜单与掉线看门狗
隧道最怕的是"静默掉线":npc 进程挂了,家里机器还在跑,但外面连不上了。针对这个,做了三层保障:
- 行前加固脚本
https://028000.xyz/pve-trip-prep.sh:出远门前在 PVE 上跑一遍,确保 npc 运行正常且开机自启、装上掉线看门狗、给所有虚机/容器设好开机自启(onboot),最后输出一份自检报告。 - 掉线看门狗:cron 每 5 分钟检查一次 npc 状态,掉线自动拉起。
- gl 快捷命令:安装到 PVE 的
/usr/local/bin/gl,输入gl就打开一个管理菜单:隧道安装/启停/自启/状态/日志、虚机和容器的电源管理、重跑加固脚本。它还带了 npc 菜单的本地缓存,断网时也能用基本功能。
这三层是"人在外地、家里没人"这个场景下总结出来的。看门狗解决"掉了能自己回来",gl 解决"人不在现场也能远程操作",行前加固解决"出发前确认一切正常"。
踩坑与注意事项
- nps 服务端的配置是纯文件,不是数据库。 客户端和隧道分别存在
/etc/nps/conf/clients.json和tasks.json里,nps.conf 管服务端自身。手改配置后必须重启 nps 才生效,改之前先备份这两个 json。签发脚本动它们之前会先读一遍做冲突检查,手改时也要养成这个习惯。 - DSM 的 auth.cgi 有登录保护。 短时间内反复调用会被限流,表现为超时或空响应,而页面本身是正常的。正确姿势是登录一次拿到 sid 后复用到底,不要写个循环反复登录。触发限流后需要冷却约 15 分钟。
- 隧道验收要看"真实效果"。 比如 28006(PVE 面板隧道),未认证时返回 HTTP 401 是正常的,说明隧道通、面板活着;22221 要看到 OpenSSH banner 才算 SSH 隧道真正可用。只看端口"通了"不够,要看对端到底返回了什么。
- 签发前先检查端口占用。 mknpc.sh 已经内置了这个逻辑(查 nps 现有任务 + 登记表),如果是手改配置,一定要先查再分配,别硬上。
- 专属安装器的 token 路径不要公开。 它是未公开路径,靠"不可猜测"做第一层保护。分享时只发给对应机器的管理员,用完即吊销,不要转发到公开渠道。
- nps 服务端本身也要做开机自启和状态监控,它挂了全家隧道一起挂。VPS 上确认过 nps 为 enabled + active,并纳入日常检查。
总结
这套隧道体系的核心就三句话:规矩(一机一 client)定边界,工具(签发/吊销/安装器)提效率,兜底(看门狗/gl 菜单/行前加固)保稳定。nps 本体只是个管道,真正的工程量都在管道之外的管理体系里。如果你也在用 nps 组家庭网络,建议先把端口池和命名规范定下来,再写签发脚本,最后补看门狗,这个顺序踩坑最少。
相关阅读:《家庭数据中心架构总览:VPS、PVE、NAS 三方分工》、《WireGuard 组网实战:把管理面板藏进 VPN》、《PVE 里跑 Docker:LXC 容器 CT702 实战》