fail2ban 实战:从 SSH 到 Web 登录接口的防护
摘要
公网服务器每天被扫描器问候几千次是常态,靠"密码够复杂"硬扛不是办法。这篇记录 fail2ban 在这套家庭数据中心的全套实践:先讲透它的工作原理(log→filter→jail→action),再讲 SSH 的 sshd jail 和 recidive 的配合,然后是 Web 登录接口的防护模式(nginx 限流返回 429 → fail2ban 盯 429 日志 → 10 分钟 8 次封 1 小时),这套模式从 vaultwarden 首创,被复制到 OpenList、Halo、图床,全家统一。最后写 filter 正则怎么写、测试时为什么必须从本机打。
目录
- 一、fail2ban 的工作原理:log→filter→jail→action
- 二、SSH 防护:sshd jail + recidive
- 三、Web 防护模式:限流 + 盯 429
- 四、全家复制:一套模式,四个站点
- 五、filter 正则怎么写:以 halo-blog-limit 为例
- 六、测试:必须从本机单 IP 打
- 七、踩坑记录
- 八、总结
一、fail2ban 的工作原理:log→filter→jail→action
配 fail2ban 之前,先理解它到底在干什么。它的工作链条是四步:
日志文件 → filter(正则匹配) → jail(计数与判决) → action(封禁)
- log:fail2ban 不主动探测,它只读日志。SSH 读
/var/log/auth.log,Web 站点读 nginx 的 access log。 - filter:一组正则表达式,从日志里捞出"失败"的行,并提取出 IP。比如 SSH 登录失败的行、HTTP 429 的行。
- jail:判决逻辑。
maxretry(最多几次)、findtime(多长时间内)、bantime(封多久)。10 分钟内 8 次失败 → 封 1 小时,就是 jail 的配置。 - action:执行封禁,默认是往 iptables/nftables 加一条 DROP 规则,bantime 到了自动解封。
理解这个链条,排查就有方向:没封禁?先看日志里有没有失败记录(log),再看正则能不能匹配(filter),再看计数够不够(jail),最后看防火墙规则加没加上(action)。四步逐段查,比瞎猜快得多。
二、SSH 防护:sshd jail + recidive
VPS 的 SSH 端口从 22 改成了 22022(防爆破的第一步:别用默认端口),密码登录保留(用户电脑/手机用密码登录)。fail2ban 配了两层:
# /etc/fail2ban/jail.local(示意)
[sshd]
enabled = true
maxretry = 5
findtime = 600    # 10 分钟
bantime = 3600    # 1 小时

[recidive]
enabled = true
# 1 天内被 sshd 封 3 次,封 1 周
maxretry = 3
findtime = 86400
bantime = 604800
sshd jail 是常规防护:10 分钟 5 次失败,封 1 小时。recidive 是"累犯加重":1 天内被封 3 次,说明不是手误,是扫描器,直接封 1 周。两层配合,误伤率低(手误 5 次内不会被封),对扫描器狠(反复来就封一周)。
实测:recidive 已经封了 14 个 IP,说明公网扫描器确实在天天问候,防护不是摆设。
三、Web 防护模式:限流 + 盯 429
Web 登录接口的防护,首创于 vaultwarden,模式是两层:
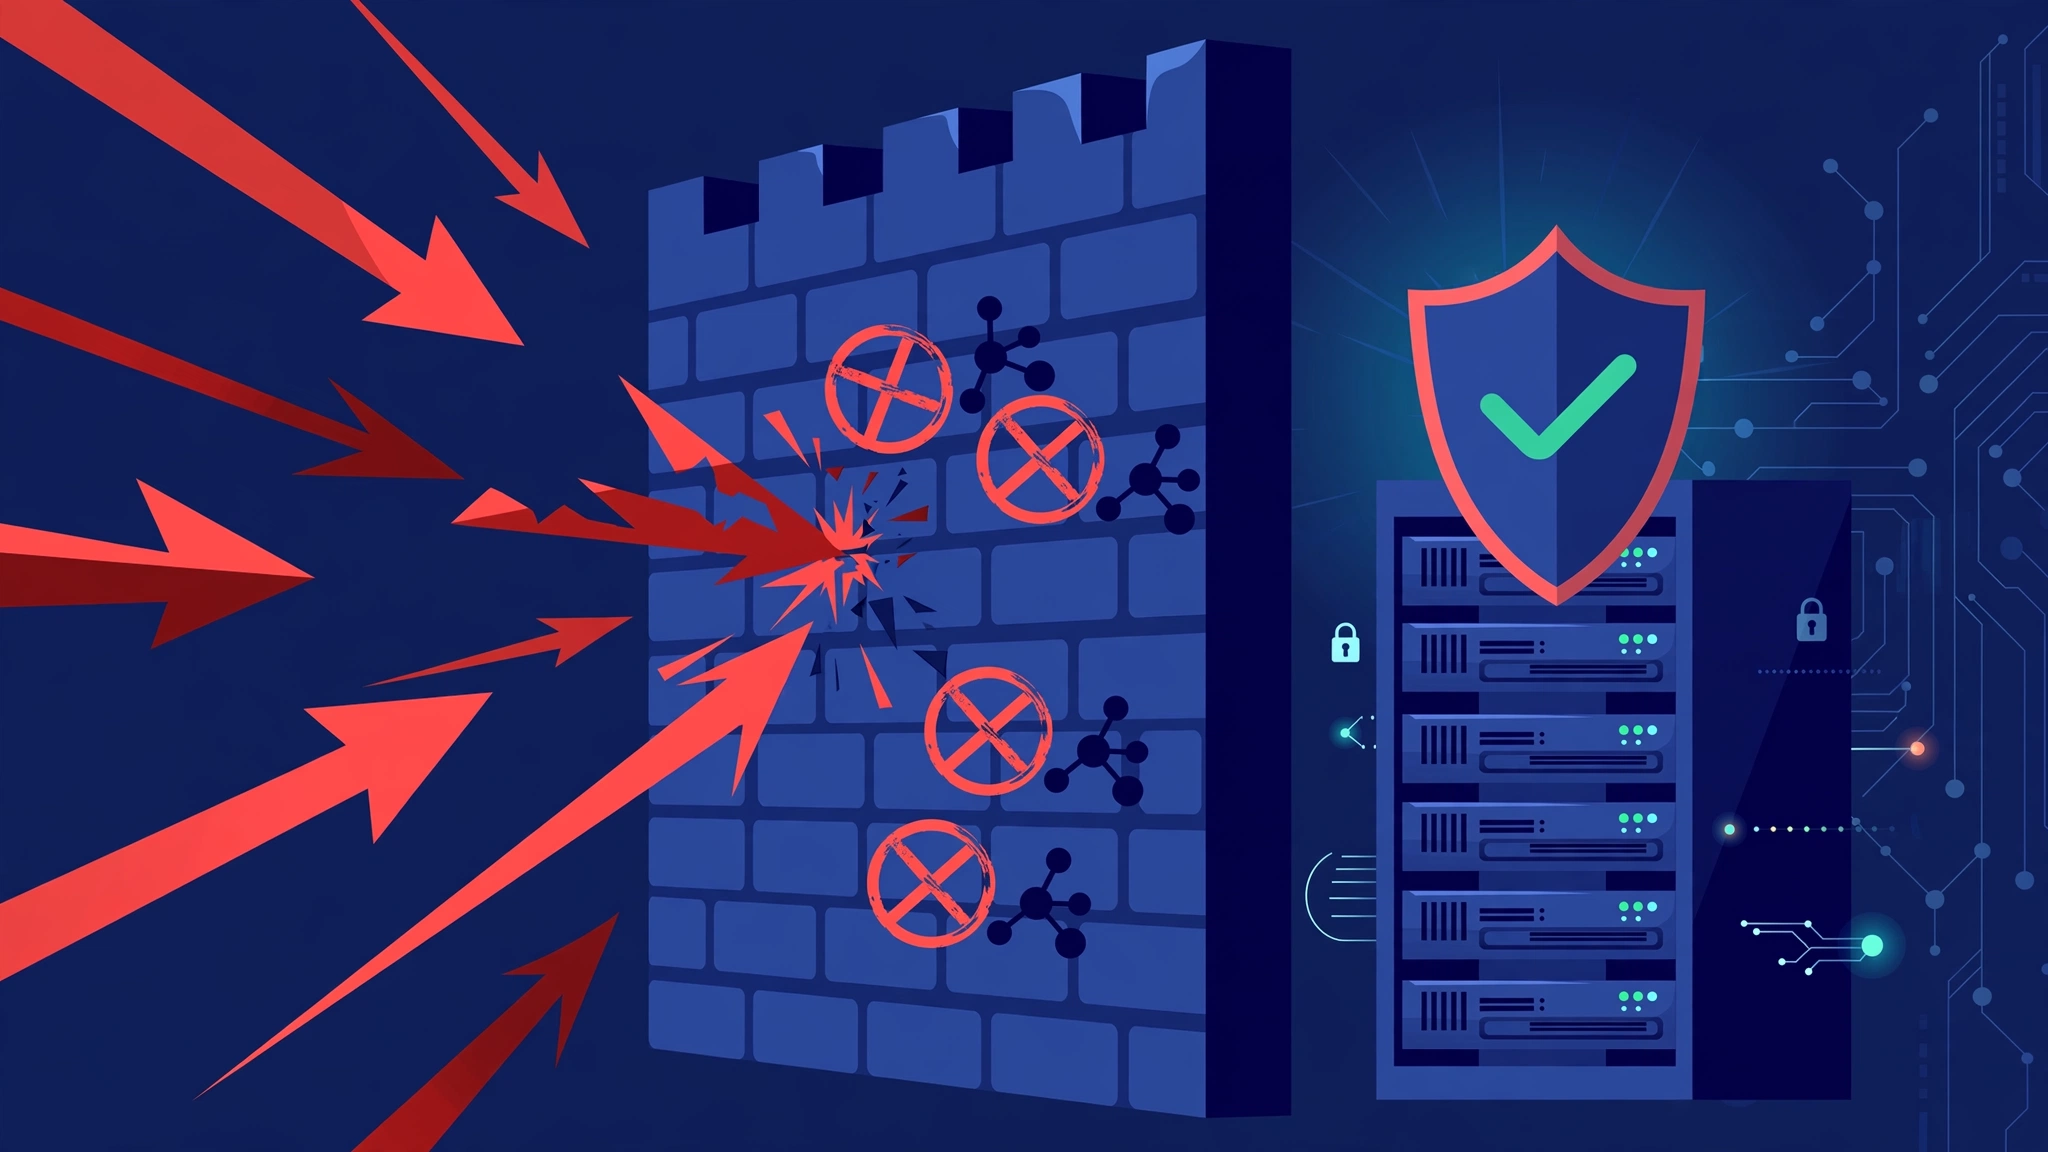
nginx 限流(5 次/分钟) → 超限返回 429 → fail2ban 盯 429 日志 → 10 分钟 8 次封 1 小时
为什么是两层? nginx 限流是"软挡":超了就回 429,不封 IP,对误伤友好(比如用户自己狂点登录)。fail2ban 是"硬封":10 分钟内攒够 8 个 429,说明不是手误,是爆破,封 IP 1 小时。软挡在前,硬封在后,误伤和防护都照顾到了。
nginx 侧的配置:
# 限流 zone 定义
limit_req_zone $binary_remote_addr zone=login:10m rate=5r/m;
limit_req_zone $binary_remote_addr zone=api:10m rate=60r/m;

# 登录接口 5 次/分钟
location /admin {
    limit_req zone=login burst=5 nodelay;
    # ...
}
# 全站 API 60 次/分钟
location /apis/ {
    limit_req zone=api burst=20 nodelay;
    # ...
}
fail2ban 侧的 jail(以 halo-blog-limit 为例):
[halo-blog-limit]
enabled = true
filter = halo-blog-limit
maxretry = 8
findtime = 600
bantime = 3600
logpath = /var/log/nginx/blog.access.log
四、全家复制:一套模式,四个站点
这套模式从 vaultwarden 首创,验证有效后,复制到全家:
| 站点 | jail 名 | 限流 | 封禁策略 |
|---|---|---|---|
| vaultwarden | vaultwarden-limit | 登录 5r/m,全站 60r/m | 10 分钟 8 次 429,封 1 小时 |
| OpenList | openlist-limit | 登录 5r/m,API 60r/m | 同上 |
| Halo 博客 | halo-blog-limit | 登录 5r/m,API 60r/m | 同上 |
| EasyImage | img-login/img-api | /admin 5r/m,/api/ 60r/m | 同上 |
统一的好处:配法一样,排查一样,新站点上线直接抄。安全策略最怕"每个站点各搞一套",最后自己都记不清哪个严哪个松。
五、filter 正则怎么写:以 halo-blog-limit 为例
filter 的核心是一个正则,从 nginx access log 里捞出 429 的行并提取 IP:
# /etc/fail2ban/filter.d/halo-blog-limit.conf(示意)
[Definition]
# 匹配状态码为 429 的 access log 行,提取客户端 IP
failregex = ^<HOST> -.*" (GET|POST) .* " 429
ignoreregex =
<HOST> 是 fail2ban 的内置宏,自动匹配 IP(v4/v6)。写完 filter,一定要用 fail2ban-regex 测试:
# 拿真实日志测试 filter,看能不能匹配到 429 的行
fail2ban-regex /var/log/nginx/blog.access.log /etc/fail2ban/filter.d/halo-blog-limit.conf
# 输出里看 matched 行数,不是 0 才算对
filter 上线前必须用真实日志测,这是铁律。正则写错了,jail 配得再好也捞不到 IP,等于没配。fail2ban-regex 跑一遍只要几秒,别省。
六、测试:必须从本机单 IP 打
限流和封禁的测试,必须从 VPS 本机单 IP 打,不能从沙箱/本地电脑打。原因:沙箱出口经 Cloudflare,每次请求换 IP,fail2ban 的"单 IP 计数"永远攒不满 8 次,测了等于没测。
# 在 VPS 本机,单 IP 快速打登录接口,看 429 和封禁
for i in $(seq 1 20); do
  curl -s -o /dev/null -w "%{http_code}\n" https://blog.028000.xyz/admin
done
# 前几次 200/401,打到第 6 次左右开始 429
# 继续打,fail2ban 日志里应出现 Ban

# 查封禁状态
fail2ban-client status halo-blog-limit
测试时注意别把自己锁外面:用 VPS 本机 IP 测试,被封了也只是本机 IP 1 小时,真被锁了 fail2ban-client unban 解一下就行。别用手机的公网 IP 测,封了更麻烦。
七、踩坑记录
坑 1:filter 正则没测,配了等于没配
最早配的时候,filter 正则直接抄的模板,没拿真实日志测。结果模板的日志格式和实际的 access log 格式对不上,一个 429 都没捞到。教训:fail2ban-regex 是 filter 上线的必经步骤。
坑 2:从沙箱测限流,永远测不出来
沙箱出口经 Cloudflare 换 IP,单 IP 计数攒不满。浪费半小时才想明白。教训:测限流从 VPS 本机打,这个细节全家通用。
坑 3:bantime 太短,扫描器无感
最早 bantime 设的 10 分钟,扫描器被封 10 分钟后继续,等于没封。改成 1 小时,配合 recidive 的 1 周,对扫描器才有威慑。封禁时长要和攻击成本匹配。
Cloudflare 场景:真实 IP 透传
如果站点前面有 Cloudflare(或其他 CDN),fail2ban 会遇到一个经典问题:nginx 日志里看到的 IP 全是 Cloudflare 的节点 IP,不是攻击者的真实 IP。按这个 IP 封,封的是 CDN,一封封一片。
解法:让 nginx 取真实 IP,再让 fail2ban 读真实 IP:
# nginx 取真实 IP(Cloudflare 场景)
set_real_ip_from 103.21.244.0/22;  # Cloudflare IP 段(官方公布)
# ... 把 Cloudflare 的所有 IP 段都加上
real_ip_header CF-Connecting-IP;
# 或用 X-Forwarded-For
# real_ip_header X-Forwarded-For;
配完后,access log 里记的是真实 IP,fail2ban 的 filter 和 jail 不用改,直接生效。验证:fail2ban-regex 跑一遍,看捞出来的 IP 是不是真实攻击 IP。
注意:set_real_ip_from 的 IP 段要用 Cloudflare 官方公布的,别自己猜。官方 IP 段偶尔会变,配完记一笔,半年检查一次。
解封与白名单:别把自己锁死
封禁是自动的,解封要会手动:
# 看谁被封了
fail2ban-client status halo-blog-limit
# 手动解封
fail2ban-client set halo-blog-limit unbanip 1.2.3.4
白名单:把自己的常用 IP(家里公网 IP、手机流量 IP 段)加进 ignoreip,避免手误把自己封了:
[DEFAULT]
ignoreip = 127.0.0.1/8 192.168.0.0/24
家里公网 IP 是动态的,ignoreip 里写死了也没用(IP 一变就失效)。动态 IP 的场景,靠"别用常用 IP 测限流"来避坑:测试从 VPS 本机打,被封了 unbanip 一下就行。
误封的代价:安全与可用的平衡艺术
fail2ban 是"宁可错杀"的工具,但错杀有代价。被封的是扫描器,皆大欢喜;被封的是用户自己,半夜 1 小时登不上博客后台,那就是事故。所以配 fail2ban 的核心不是"封得有多狠",而是"误伤有多低"。
误伤主要来自三个地方。第一,用户自己的误操作:密码记错了,连点 6 次登录,触发 5 次/分钟的限流,拿到几个 429,再多点几次,fail2ban 封 1 小时。对策是限流和封禁之间留缓冲:限流 5 次/分钟是"软挡",fail2ban 要 10 分钟 8 次 429 才"硬封"。正常人点错 5 次会停下来想想,扫描器不会停。这个缓冲就是区分"人"和"机器"的分水岭。第二,共享 IP:一家人、一个公司出口同一个公网 IP,一个人触发限流,全家被封。对策是 ignoreip 白名单,把常用出口 IP 加进去。家里公网 IP 是动态的,白名单写死没用,那就靠"测试从 VPS 本机打"来避开——别用家里的 IP 测限流。第三,CDN 前置:前面讲了,CDN 后面全是节点 IP,不配 real_ip,封的是 CDN,一封封一片,正常用户全被误伤。这是配置问题,不是策略问题,但后果最严重。
还有一个维度:封禁时长。bantime 1 小时是平衡点:对扫描器,1 小时足够打乱它的节奏(扫描器讲究效率,被封 1 小时就换目标了);对误伤的用户,1 小时是"能忍"的上限,再长就有人要打电话了。recidive 的 1 周是给"惯犯"的:1 天内被封 3 次,基本不可能是误操作。分层封禁的本质,是用"行为模式"区分"误伤"和"攻击",而不是一刀切。
最后,fail2ban 只是纵深防御的一层。它前面有:改默认端口(SSH 22022)、关公网暴露(管理面板进 VPN)、强密码、限流。它后面有:日志审计、异地备份。任何一层被突破,都有下一层顶着。把 fail2ban 当"唯一的防线",是本末倒置;把它当"纵深的一层",才配得上它的位置。安全是体系,不是工具。
日志:fail2ban 的眼睛
fail2ban 只读日志,日志就是它的眼睛。眼睛不好,再聪明的脑子也白搭。日志层面有三个要注意的。
一是日志轮转。 nginx 的 access log 每天轮转(logrotate),fail2ban 要能跟上轮转后的新文件。好在 fail2ban 原生支持(它用 pyinotify 跟踪文件),但logrotate 的配置里,create 模式和 copytruncate 模式对 fail2ban 的影响不同。copytruncate 是"原地截断",文件句柄不变,fail2ban 无感;create 是"新建文件",fail2ban 要重新打开。两种都能工作,但配 logrotate 时知道这个区别,出问题不慌。
二是日志格式。 filter 的正则,是按某种日志格式写的。nginx 的 log_format 改了(比如加了 $request_time),正则可能就匹配不上了。改日志格式,顺手跑一遍 fail2ban-regex,确认 filter 还认得新格式。日志格式和 filter 是"契约",一边变了,另一边要跟。
三是集中日志。 服务多了,日志散在各处:VPS 的 nginx 日志、CT700 的 vaultwarden 日志、PVE 的 auth.log。fail2ban 是单机工具,每台机器配自己的 jail。但"看"日志的时候,集中起来看更高效:rsyslog 或 loki 把日志汇到一处,排查攻击时能看到"这个 IP 先扫了 SSH,又扫了博客登录",全貌一目了然。集中日志是进阶项,服务上规模后值得做。
日志是安全的"黑匣子"。攻击发生时,日志是唯一的真相;fail2ban 是"根据真相自动动手"的那个。真相要全(格式对、轮转跟得上),动手才准。
fail2ban 的替代:CrowdSec 一眼
fail2ban 是单机防御,CrowdSec 是"群体免疫":它把全网的攻击 IP 情报共享,你的服务器被扫了,全网都知道这个 IP 是坏人,提前封。这套家庭场景,fail2ban 够用,但知道有 CrowdSec 这回事,视野更全。
| 维度 | fail2ban | CrowdSec |
|---|---|---|
| 原理 | 读本地日志,单机判决 | 本地检测 + 全网情报共享 |
| 配置 | 正则 + jail,简单 | 概念多(scenario、bouncer),上手陡 |
| 资源 | 极轻 | 稍重(要跑 agent) |
| 适用 | 个人、小规模 | 多服务器、有公网业务 |
选型建议:现在的规模,fail2ban 够了,轻、稳、熟。哪天服务器上了两位数,或者被定向攻击,再考虑 CrowdSec。工具没有好坏,只有"合不合适"。fail2ban 的轻量,在这个规模是优点,不是缺点。
安全没有银弹,fail2ban 只是纵深中的一层。把它配好、测好、和全家统一,就是这篇的全部要求。剩下的,交给下一层。记住测试铁律:从 VPS 本机单 IP 打,别从换 IP 的沙箱打。记住配置铁律:限流和封禁一起上,单用一个都是半套。记住运维铁律:封禁列表定期看,别把自己人关在门外。误封了,用 fail2ban-client unban 解,别等 1 小时。解封命令记在手边,关键时刻救急。fail2ban 是看门的,不是关门的,看门的核心是"放对的人进,拦错的人"。
fail2ban 的日志值得定期翻。grep "Ban" /var/log/fail2ban.log | tail -20,看看最近封了谁。被封的 IP 里,如果有国内云厂商的段,是扫描器;如果有境外冷门国家的,是肉鸡;如果反复出现同一个 IP,是定向的。看封禁日志,能读出攻击的"画像"。画像清楚了,防御才有针对性:扫描器多,就收紧阈值;定向多,就查是不是信息泄露了(比如 GitHub 上暴露了域名)。日志不只是记录,是情报。
八、总结
fail2ban 的实践三句话:理解四步链条(log→filter→jail→action),SSH 用 sshd+recidive 两层,Web 用"nginx 限流回 429 + fail2ban 盯 429"两层。全家统一模式,新站点直接抄。两个铁律:filter 上线前用 fail2ban-regex 拿真实日志测;测试从 VPS 本机单 IP 打。公网扫描器天天在,防护不是摆设,recidive 封掉的 14 个 IP 就是证明。
相关阅读:《WireGuard 组网实战:把管理面板藏进 VPN》、《Halo 博客从零搭建:2.26.1 + Hao 主题全记录》。